Betreiben Sie offene KI-Modelle auf dedizierter GPU-Infrastruktur im europäischen Rechenzentrum.
Unverbindlich · Antwort innerhalb von 1–2 Werktagen
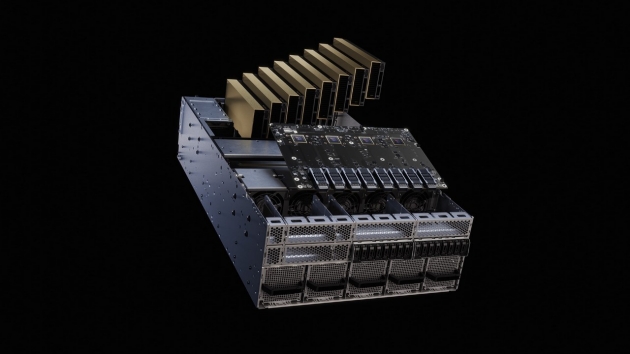
Dedizierte GPU-Server, betrieben von GEKI.
Für KI-Inferenz gibt es nicht den einen richtigen Server.
Welche Infrastruktur sinnvoll ist, hängt davon ab, was Sie damit machen wollen:
Welche Anwendung soll betrieben werden?
Interner Assistent, Dokumentenverarbeitung, Coding Agent, Customer Service oder KI-Funktion in Ihrem Produkt.
Wie viele Nutzer greifen gleichzeitig darauf zu?
Ein internes Team stellt andere Anforderungen als eine SaaS-Anwendung mit hunderten parallelen Requests.
Wie schnell müssen Antworten kommen?
Interaktive Anwendungen brauchen andere Durchsätze als Batch-Verarbeitung im Hintergrund.
Wie viel Kontext wird verarbeitet?
Lange Dokumente und große Context Windows benötigen zusätzlichen GPU-Speicher.
Welche Daten werden verarbeitet?
Bei sensiblen Daten können Standort, Mandantentrennung und dedizierte Infrastruktur entscheidend sein.
Wie hoch ist die erwartete Nutzung?
Je höher die dauerhafte Auslastung, desto interessanter wird eigene dedizierte GPU-Kapazität gegenüber Token-basierten APIs.
GEKI nimmt diese Anforderungen und dimensioniert daraus die Infrastruktur.
Erst danach entscheiden wir, welche GPUs sinnvoll sind.
Nicht jeder Workload braucht eine H100. Und nicht für jedes Modell ist dieselbe GPU die wirtschaftlichste Wahl.
NVIDIA RTX PRO 6000 Blackwell
96 GB VRAM pro GPU
Starke Plattform für viele aktuelle Open-Weight-Modelle und produktive Inferenz. Typische GEKI-Systeme nutzen mehrere RTX PRO 6000.
RTX PRO 6000 KI Fabrik ansehen →AMD Instinct MI350P
144 GB HBM3e pro GPU
Für Workloads mit größerem Speicherbedarf und hoher Inferenzlast. Multi-GPU-Systeme ermöglichen mehrere hundert Gigabyte bis über ein Terabyte GPU-Speicher.
AMD MI350P KI Fabrik ansehen →Größere GPU-Systeme
Individuell
Wenn Modell oder Last über diese Systeme hinausgehen, planen wir größere Multi-GPU-Konfigurationen individuell — passend zu Ihrem konkreten Workload.
Infrastruktur konfigurieren →Das größte Modell ist nicht automatisch das beste Modell.
Für viele Unternehmensanwendungen ist ein kleineres Modell:
GEKI hilft deshalb bei der Auswahl des Modells anhand der Anwendung.
Kleine und mittlere Modelle
Für klar definierte Aufgaben wie Klassifikation, Extraktion, RAG oder einfache Agenten kann ein kompaktes Modell vollkommen ausreichen. Der Vorteil: hoher Durchsatz bei vergleichsweise wenig Hardware.
Große Open-Weight-Modelle
Für komplexes Reasoning, Coding oder anspruchsvolle Agenten können größere Modelle sinnvoll sein. Dann steigen vor allem GPU-Speicher und Hardwarebedarf.
Sehr große Frontier-Modelle
Auch sehr große Open-Weight-Modelle können auf dedizierter GEKI-Infrastruktur betrieben werden. Hier prüfen wir zuerst, ob der zusätzliche Modellumfang für die Anwendung tatsächlich notwendig ist – oder ob ein kleineres Modell wirtschaftlich die bessere Lösung liefert.
Ein gutes Beispiel dafür, warum Modell und Hardware gemeinsam betrachtet werden müssen.
DeepSeek V4 Flash lässt sich auf einer vergleichsweise kompakten Infrastruktur betreiben:
Die komplette Infrastruktur inklusive Hosting und GEKI Stack — Preis auf Anfrage.
Bei hoher Auslastung kann dadurch ein sehr niedriger effektiver Preis pro verarbeitetem Token erreicht werden.
Sie kaufen bei GEKI aber keine Token.
Sie bekommen die Infrastruktur.
Wenn Hardware und Modell feststehen, übernimmt GEKI den produktiven Betrieb.
Infrastruktur
Bereitstellung der dedizierten GPU-Server im europäischen Rechenzentrum.
Inference Stack
Installation und Optimierung der Inference Engine und Modelle.
API
Bereitstellung über eine OpenAI-kompatible API.
Monitoring
Überwachung von Hardware, Inferenz und Auslastung.
Updates
Treiber, Runtime und Modellversionen werden kontrolliert aktualisiert.
Support
Ein Ansprechpartner für Hardware und KI-Infrastruktur.
Eine öffentliche API ist für Tests und geringe Nutzung häufig die einfachste Lösung.
Eigene dedizierte Infrastruktur wird interessant, wenn Sie:
Wenn sich dedizierte Infrastruktur für Ihren Workload noch nicht rechnet, sagen wir Ihnen das ebenfalls.
Sie müssen nicht wissen, welche GPU oder welches Modell Sie brauchen. Sagen Sie uns, was die KI machen soll, wie viele Nutzer oder Requests Sie erwarten und welche Anforderungen an Geschwindigkeit und Datenhaltung gelten — GEKI leitet daraus Modell, Hardware und Infrastruktur ab.

