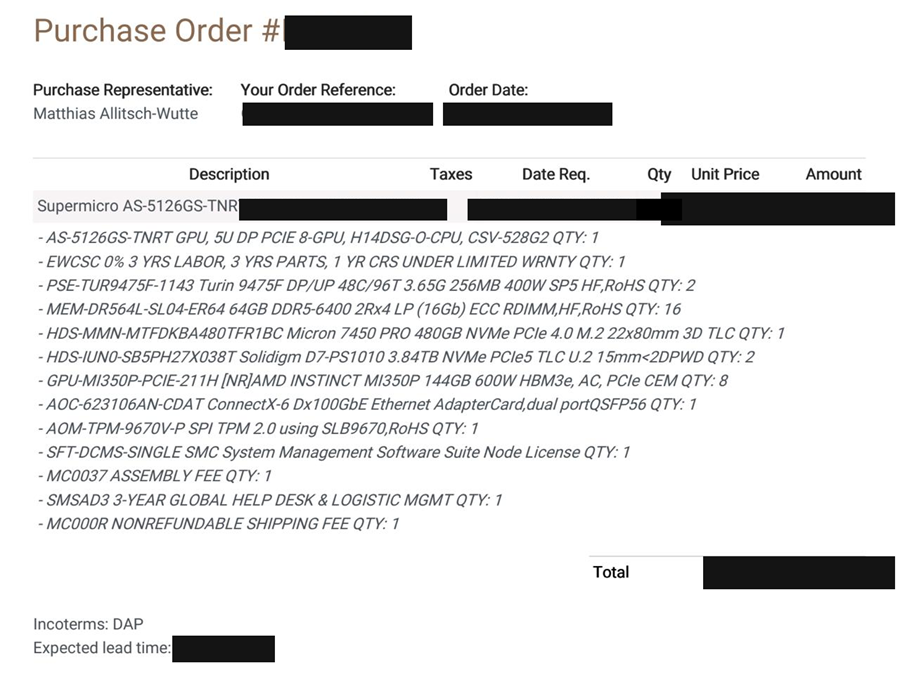
Warum wir AMD Instinct MI350P GPUs bestellt haben: mehr Speicher, normales Rechenzentrum, komplett gemanagt in AT und DE.
Matthias Allitsch-Wutte · GEKI Gründer
2. September 2026 · 6 Min.
Bisher führte auch für uns kein Weg an NVIDIA vorbei. Die RTX PRO 6000 (Blackwell) sind Top-GPUs – und immer noch eine gute Wahl, wenn man im NVIDIA-Ökosystem bleiben möchte. Unsere ersten KI-Fabriken laufen darauf. Für die nächsten haben wir jetzt bewusst AMD bestellt – Supermicro-Server mit 8× AMD Instinct MI350P. Warum diesmal nicht NVIDIA als Basis? Drei Gründe:
GEKI baut und betreibt KI-Fabriken für Inferenz – für Unternehmen, die KI regional und günstig für ihre eigenen Anwendungen nutzen wollen: ohne Lieferantenrisiko der Hyperscaler, ohne ihre Daten in US-Rechenzentren, mit voller Datenhoheit – sich aber nicht um Hardware, den Inferenz-Stack oder das Rechenzentrum kümmern möchten.
Sie bekommen von uns OpenAI-kompatible API-Endpunkte – also den Komfort eines Hyperscalers, nur eben in österreichischen und deutschen Rechenzentren. Den Standort wählen Sie. Wir betreiben die KI-Fabrik 24/7 und managen Modelle, Routing und Skalierung. Sie nutzen KI für Ihre Anwendungen.
Ein Supermicro-Server mit 8× AMD Instinct MI350P (je 144 GB HBM3e), AMD EPYC CPUs, 1 TB RAM und schnellem NVMe-Speicher. Macht 1.152 GB GPU-Speicher in einer einzigen Maschine.
Moderne KI-Modelle brauchen vor allem eines: viel VRAM. Die Größe entscheidet, welches Modell überhaupt läuft – das war der Hauptgrund für AMD. Die MI350P verwendet außerdem HBM3e, nicht GDDR wie die RTX PRO 6000: deutlich mehr Bandbreite. Beispiel: DeepSeek V4 Flash (284 Mrd. Parameter) braucht rund 160 GB allein für die Gewichte. Auf einer einzelnen RTX PRO 6000 (96 GB) läuft das nicht. Auf zwei Stück (192 GB) wird es für mehrere Requests gleichzeitig zu knapp. Mit 2× MI350P (288 GB) geht es sich gut aus.
(Mehr dazu in unserem VRAM-Vergleich: wie viel Speicher Qwen, DeepSeek und Kimi wirklich brauchen.)
Wir haben bewusst die luftgekühlte PCIe-Variante (MI350P) gewählt. Jede GPU zieht rund 600 W – der ganze Server läuft damit in einem normalen Rechenzentrums-Rack, ganz ohne Spezial-Flüssigkeitskühlung oder Hyperscaler-Standort. Genau deshalb können wir mehr regionale Standorte anbieten.
Genau das ist unser Punkt: Wir bauen KI-Fabriken für mittelständische Unternehmen, die souveräne KI wollen – fast Spitzenqualität mit offenen Modellen, aber ohne Hyperscaler-Rechenzentrum. Die Hardware steht dort, wo Ihre Daten liegen sollen: in einem österreichischen oder deutschen Rechenzentrum – den Standort wählen Sie.
Die Modelle, die unsere Kunden betreiben, ändern sich laufend – alle paar Monate kommt ein besseres offenes Modell. Der große Speicher der MI350P ist deshalb eine Investition in die Zukunft: Dieselbe Fabrik trägt heute DeepSeek V4 Flash oder GLM 5.3 – und morgen die nächste, größere Generation. Die Hardware bleibt, die Modelle werden besser.
Über GEKI ist immer die passende Konfiguration verfügbar – von einer einzelnen GPU bis zum ganzen Server. Einstieg schon ab 1 GPU. Unsere Empfehlung (alles offene Modelle):
| GPUs | Modellbeispiele | Warum es gut passt |
|---|---|---|
| 1 | Qwen3.8 27B | kompakt, starkes Modell auf wenig Hardware – guter Einstieg |
| 2 | DeepSeek V4 Flash | starkes Agenten-Modell, offen – viel Leistung fürs Geld |
| 4 | GLM 5.3 Flash | mehr Tempo und Qualität für anspruchsvollere Workflows und mehr parallele Nutzer |
| 8 | GLM 5.3 (volle Version) | Frontier-nahe Qualität für die anspruchsvollsten Anwendungen |
Sie sagen uns, was Sie laufen lassen wollen – wir liefern die passende Ausbaustufe.
Hardware allein ist austauschbar und wird sich immer wieder ändern. Den Unterschied macht die Software-Schicht darüber – Inferenz-Routing, Auslastung, mehrere Modelle. Sie macht aus preiseffizienter Hardware eine wirtschaftliche KI-Fabrik. Genau deshalb konnte ich diesmal AMD wählen: weil unser Betrieb die Effizienz liefert, nicht die teuerste GPU.
GEKI betreibt komplett gemanagte KI-Fabriken mit offenen Modellen in österreichischen und deutschen Rechenzentren. Der Komfort eines Hyperscalers (OpenAI-kompatible API-Endpunkte), aber lokal, souverän und günstig. Sie kümmern sich um Ihre Anwendung – wir um alles darunter.
GEKI betreibt komplett gemanagte KI-Fabriken mit offenen Modellen in österreichischen und deutschen Rechenzentren. Den Standort wählen Sie. Sehen Sie die Preise oder sprechen Sie mit uns.